En el trabajo ya estábamos usando subagentes, pero me metí de lleno cuando hice el curso de subagentes de Claude Academy. Armé ocho en dos repos, y en unas 18 horas los de jobfit corrieron 27 veces, 11 ya como agentes de verdad. Encontraron cosas que a mí se me habían pasado, se equivocaron un par de veces, y escribir sus reglas me destapó bugs antes de correrlos.
Un subagente es una instancia aparte a la que le delegas una tarea. Corre en su propio contexto, hace lo suyo, y a tu conversación principal solo vuelve el resumen. Todo el ruido del camino, los archivos que leyó, los greps, las búsquedas, se queda afuera.
Mientras hacía el curso me acordé de cuando Naruto entrena con clones de sombra: saca un montón en un campo, cada uno intenta cortar una hoja con su chakra, y cuando se deshacen, lo que aprendió cada clon le llega a él. Un subagente es eso, con dos diferencias. Al original no le llega todo lo que vivió el clon, solo el resumen. Y el clon de Naruto se acuerda de todo lo que vivió Naruto; el subagente no se acuerda de nada de tu conversación: sabe lo que dice su archivo y lo que le pasan al encargarle la tarea.
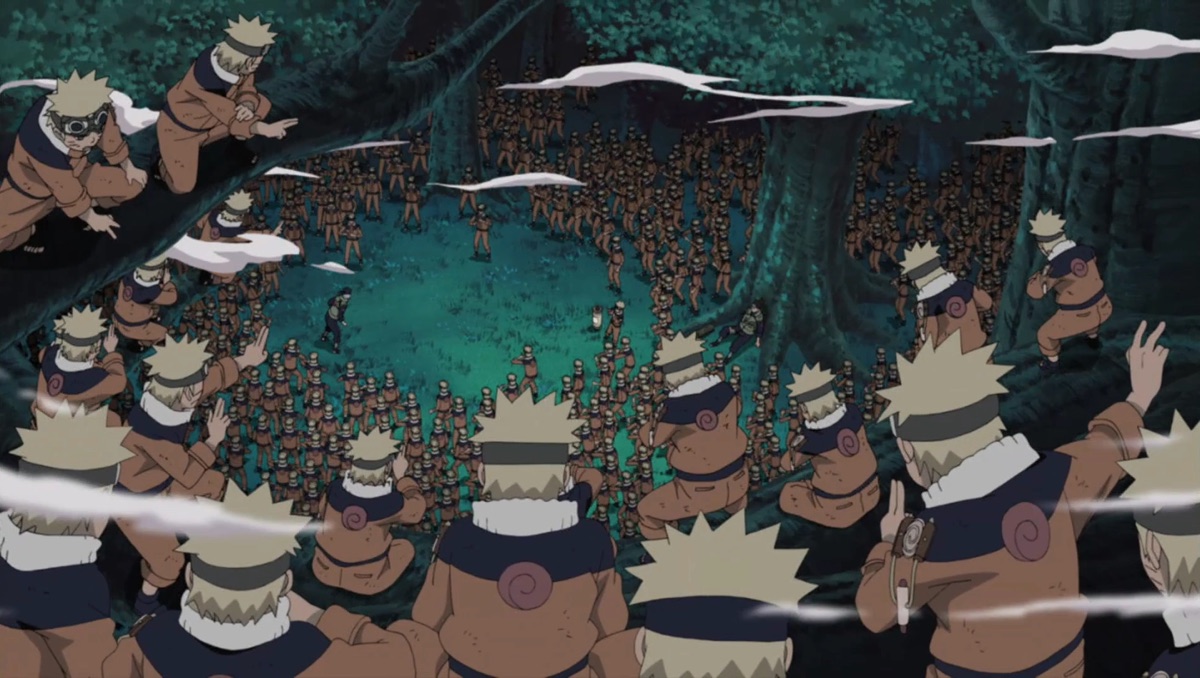 Ver la imagen en tamaño completo
Naruto contra Mizuki, la primera vez que usa los clones de sombra. Naruto, Studio Pierrot.
La segunda diferencia es la que importa.
El error es hacerlos expertos#
Lo primero que uno quiere escribir es "eres un experto en React, revisa este código". Eso no sirve: el modelo ya sabe React. Un subagente que se declara experto no puede hacer nada que tu conversación principal no haga igual. Y eso que el ejemplo del propio curso arranca con "You are an expert code reviewer".
Lo que el modelo no sabe es que en mi repo un /blog/ hardcodeado mandó a los lectores en español al blog en inglés. O que agregar un link al nav empuja los headings debajo de la barra en celular. Eso no está en ningún dataset. Está en mi historial de bugs.
Mi site-reviewer tiene anotado, al lado de esas dos reglas, que eso ya pasó. No es un experto en Next.js. Es el que se acuerda de las veces que la cagué.
Y ahí está la parte incómoda: mis subagentes no le sirven a nadie más. Están llenos de tokens de diseño de mi CSS, de nombres de rutas, de decisiones que solo aplican a mis dos repos. Aunque los copiaras a tu repo, para ti serían ruido. Eso no es un defecto del diseño, es el diseño.
Los ocho#
Cuatro en el repo de este blog y cuatro en jobfit, el proyecto de mi post sobre evaluar un prompt.
| Agente | Repo | Le delego | Modelo | Escribe |
|---|---|---|---|---|
| post-editor | blog | revisar un post antes de compartirlo | opus | no |
| post-translator | blog | traducir un post al otro idioma | opus | sí |
| prod-checker | blog | confirmar que un deploy llegó a producción | sonnet | no |
| site-reviewer | blog | revisar un PR contra las reglas del repo | opus | no |
| docs-drift-auditor | jobfit | revisar los números del README, el SPEC y el CLAUDE.md contra la base de datos | sonnet | no |
| eval-disagreement-analyst | jobfit | entender por qué el scorer y mis labels no coinciden | opus | no |
| repo-rules-reviewer | jobfit | revisar cambios de código contra las reglas del repo | opus | no |
| source-assessor | jobfit | evaluar si una fuente nueva de vacantes se puede usar | sonnet | no |
Siete de ocho no tienen Write. El único que lo tiene es el traductor. Eso no salió por casualidad: el curso insiste en darle a cada uno solo las tools que necesita, y cuando te sientas a decidirlo, resulta que casi ninguno necesita escribir.
Pero no tener Write no es lo mismo que ser de solo lectura. Los ocho tienen Bash, y con Bash también se escribe un archivo. El site-reviewer tiene escrito que nunca edita archivos, y en su única corrida creó dos scripts de prueba dentro del repo y después los borró. Los siete sin Write son de solo lectura porque se lo pido, no porque no puedan.
La otra regla la apliqué sin darme cuenta y la escribo ahora que la veo: opus donde el juicio es el producto, sonnet donde el trabajo es verificar. El editor juzga un texto. El analista de desacuerdos interpreta por qué un scorer y yo no coincidimos. Esos van en opus. El prod-checker corre curls y compara strings, el docs-drift-auditor compara números del README contra la base de datos. Eso no necesita opus.
Aparte de estos ocho, en el trabajo usamos subagentes en el día a día para cosas puntuales. Del código no puedo dar detalles, pero sí de para qué los usamos:
- Revisar un PR antes del review humano, contra el comportamiento que ya existe, buscando qué se puede romper.
- Rastrear un campo desde el request del BFF hasta la UI, con cada transformación y el archivo donde cambia de forma.
- Convertir un ticket en un plan: qué archivos tocar, qué APIs están involucradas y qué tests agregar, a partir del código y no a ciegas.
- Buscar la causa de un bug sin arreglarlo todavía: le pido las tres causas más probables y qué evidencia descartaría cada una.
Funcionan por lo mismo que los míos: conocen ese código y tienen un encargo concreto, no se declaran expertos.
Lo que encontraron mis subagentes#
El post-editor lo corrí sobre mi primer post, el de cómo está hecho este blog, uno que ya había publicado y que además había revisado con otra sesión de Claude. O sea, dos pares de ojos encima. Y esa primera vez ni siquiera fue el agente: la sesión era de antes de crearlos, así que le pedí a un subagente genérico que leyera el archivo del post-editor y lo siguiera.
Encontró una contradicción adentro del propio post: la tabla decía "Dependencias: ninguna" y dos párrafos más abajo decía "10 dependencias directas". Ni yo que lo escribí ni el revisor lo vimos.
Encontró que mis números medían otra cosa. Los 9 KB eran solo el HTML comprimido, y los 10 segundos de build los había medido con caché. Después los medí en frío: 14.5, 11.7 y 10.8 segundos.
Y encontró esto, que es lo mejor: yo tenía escrito "Google dice oficialmente" sobre si un blog va mejor en subdominio o en subcarpeta. Esa frase la había agregado por sugerencia del otro revisor. El agente buscó en la web y no existe tal documentación de Google, solo declaraciones de John Mueller. Un revisor metió un dato sin verificar y otro agente, que no había participado en la conversación, lo cachó.
Eso es exactamente lo que el curso dice sobre por qué un reviewer aparte funciona mejor: el que escribió algo no lo revisa bien, porque lo está leyendo con el recuerdo de haberlo escrito.
Ya como agente de verdad, lo corrí dos veces sobre mi segundo post, el de jobfit. La primera me devolvió "No compartir todavía", con cuatro problemas de fondo. La segunda, sobre las correcciones, cachó una frase que ya no era cierta: yo decía que las 135 filas de scores seguían en la base de datos, y el re-score había reemplazado 39.
El prod-checker lleva cuatro corridas, la primera también con un genérico siguiendo su archivo, y en ninguna encontró nada. Pero su regla más útil nació de un episodio real: una sesión me insistió tres veces en que mi deploy no había llegado a producción, y era caché de su lado. Ahora ese agente tiene escrito que, antes de culpar al caché, busque en el HTML vivo un string que el deploy haya introducido.
Y el site-reviewer me dio su hallazgo más útil antes de correr. Escribiendo sus reglas de SEO me di cuenta de que mis páginas de tags con noindex seguían apareciendo en el sitemap. El bug salió de escribir la regla, no de correr el agente. Esa distinción me parece más importante que todo lo demás: escribir la restricción te obliga a ir a verificar si la estás cumpliendo, y eso ya vale aunque el agente nunca se ejecute.
En jobfit pasó lo mismo. Revisar los archivos de los cuatro agentes antes de estrenarlos destapó que una regla de mi CLAUDE.md estaba mal redactada, y que por eso el reviewer iba a marcar como violación, en cada revisión, un archivo que hacía justo lo que yo quería permitir; que dos agentes describían mal cómo se versiona el prompt; y que mi CLAUDE.md decía que la rúbrica vivía en una carpeta que ni existe en el repo. Todo eso quedó commiteado trece minutos antes de la primera corrida.
jobfit: 27 corridas en 18 horas
La descripción de cada agente le dice a Claude cuándo usarlo sin que yo se lo pida: el reviewer antes de cada commit de código, el auditor antes de tocar los docs y después de cada cambio que mueva un número. Así que en unas 18 horas corrieron 27 veces: 15 el repo-rules-reviewer, 11 el docs-drift-auditor y una el analista de desacuerdos. Las primeras 16, otra vez, con un genérico siguiendo el archivo.
El mejor hallazgo fue del reviewer. Yo había agregado un flag --labels-only para scorear solo las 79 vacantes etiquetadas, y todos los tests pasaban. Pero el comando leía el flag y lo perdía antes de la consulta, así que habría scoreado 202 vacantes en vez de 79. Para darte una idea, scorear 202 vacantes, cuando lo hice después en dos corridas, costó $1.81. Los tests no lo veían porque llamaban directo a la función de abajo, no al comando. El reviewer lo cachó antes de gastar un centavo.
El auditor encontró que el README decía que la queue del 23 de agosto tenía 45 vacantes, cuando el archivo de ese día tenía 5, y otros números que ya no cuadraban con la base de datos.
Y también se equivocó. En esa misma corrida dijo que un 5.3% del README no se reproducía con ningún dato: había dividido entre el número equivocado. Lo di por bueno, entró como error en la lista de datos verificados que armé para escribir el post anterior, y lo desmintió una corrida posterior. El error lo cachó un agente, pero pasó por mí sin que lo revisara.
82k tokens que en realidad eran 480k#
Acá viene la parte que el curso no cubre.
El pitch es que los subagentes te ahorran contexto. Es cierto, pero solo para el hilo principal, y no te salvan de tus propias sesiones. Cada subagente corre sus propios requests.
Y esos requests suman más de lo que parece. Cuando termina una corrida, Claude Code te dice cuántos tokens usó el subagente: 82k la del post-editor sobre mi primer post. Ese número es el tamaño del contexto al final, no lo que procesó. Para llegar ahí hizo 8 requests, y cada uno volvió a mandar todo lo acumulado: en total unos 480k tokens, casi todos leídos de caché. Y el site-reviewer fue el clon que se deshizo sin devolverme nada: hizo 38 requests, pasó de 2 millones y se cortó al llegar al límite del plan sin entregar el reporte.
En jobfit, las 27 corridas procesaron casi 35 millones de tokens, 92.7% de caché. El que más se llevó fue el docs-drift-auditor, justo el que puse en sonnet porque solo verifica: 81% de los tokens y 388 de los 503 requests, con una sola corrida de 6.5 millones. El mismo panel de uso de Claude Code te sugiere poner un modelo más barato en los subagentes simples, y eso hice. Pero un modelo más barato abarata cada request, no le quita requests, y cada uno reenvía todo el contexto acumulado. Lo que pesó fue cuántas veces volvió a mandar todo, no el modelo. Y como a Naruto, el cansancio también vuelve.
En el panel de uso de Claude Code, vista semanal (es aproximado, solo cuenta las sesiones de esta máquina, y es la semana en que armé los agentes): 93% de mi uso estuvo arriba de 150k de contexto, y 67% en sesiones de más de 8 horas. O sea, los subagentes deberían evitar que el hilo principal crezca, y el contexto se me dispara igual. El problema no es el patrón. Es que dejo sesiones abiertas todo el día y no hago /clear al cambiar de tema.
La contradicción que sí tengo#
El curso advierte contra los pipelines secuenciales, y mi flujo es uno: editar, traducir, revisar el PR, verificar producción. Pero cada paso lee el archivo del repo, no el resumen del anterior, así que no se pierde nada en el traspaso.
Lo que todavía no sé#
El source-assessor nunca ha corrido, y el analista de desacuerdos corrió una sola vez, así que lo que digo de ellos vale como diseño, no como evidencia. Del resto hay historial: nueve corridas en el blog y 27 en jobfit.
Que un reporte salga mal ya me pasó de las dos formas. Con el 5.3% de jobfit se equivocó el agente. En la revisión de este mismo post, el editor marcó como inventados unos builds que sí había medido, porque el dato que le pasé estaba incompleto: ahí el agente hizo bien su trabajo con un encargo a medias. Por eso sigo leyendo sus reportes con desconfianza.
Por ahora me quedo con esto: un subagente útil es tan específico que no le sirve a nadie más. No es un experto, es un clon de sombra que solo sabe lo que le dejé escrito.
Si armaste un subagente que solo le sirve a tu repo, cuéntame qué le delegaste. Y si quieres el próximo post, está el feed RSS.