El 22 de agosto empecé a correr jobfit con el threshold en 70. Ese día la queue tenía una vacante. Al día siguiente bajé el número a mano hasta que salieron cinco, y no lo volví a mirar en quince días.
No me senté a evaluar el scorer hasta el 7 de septiembre. Y resulta que el threshold no era el único problema.
jobfit es un proyecto personal que corre en una laptop Dell vieja que convertí en server (eso da para otro post). Es un pipeline de tres stages: el stage 1 trae vacantes remotas de cinco fuentes, el stage 2 es un prefilter con reglas deterministas que tira lo que claramente no va, y en el stage 3 un LLM le pone score a cada vacante contra mi CV, con una sola llamada y sin agente. Lo que pasa el corte termina en una queue en Markdown. El README de jobfit tiene el detalle.
El primer día bajé el threshold a mano#
El threshold entró al repo el 22 de agosto, como una constante. No lo medí, y para cuando lo bajé ya estaba escrito en tres archivos:
# src/jobfit/queue.py
DEFAULT_THRESHOLD = 70

# src/jobfit/evals.py
parser.add_argument("--threshold", type=int, default=70)

# src/jobfit/score.py
if score.why_not or score.fit_score < 70:
Para el 23, jobfit había traído 846 vacantes y 135 llegaron al stage 3. Qué rechazó el prefilter ese día ya no lo puedo reconstruir, porque los veredictos se sobrescriben en cada run. Las 135 filas de scores sobreviven en un backup de la base de datos, porque el re-score de septiembre reemplazó 39 de ellas.
La queue del 23 tiene cinco vacantes: 78, 68, 60, 58 y 58. Cuatro están debajo de 70, así que ese día bajé el threshold a mano hasta que hubo algo que leer, y qué valor le pasé no quedó registrado en ningún lado. Después no volví a generar una queue hasta el 7 de septiembre: quince días sin mirar el número, pensando que el mercado andaba flojo.
Evaluar un LLM empieza con 39 labels a ciegas#
El 7 de septiembre etiqueté 39 vacantes, apply o skip, sin ver el score del modelo; la herramienta lo esconde. Lo que no puede esconder es que yo ya había leído las queues del 22 y el 23: Cosuno (78) y Sur (68) quedaron en el set, y la única que pasa a 70 es una que ya había visto con su número.
A threshold 70, de las 22 que después marqué apply, habría salido una. Precision 1 de 1, recall 1 de 22. Y el modelo no estaba roto, ordenaba bien:
| label | n | rango | mediana |
|---|---|---|---|
apply | 22 | 15 – 78 | 33 |
skip | 17 | 8 – 26 | 18 |
Lo que estaba mal era la escala. La rúbrica decía 100 puntos, pero en las 135 vacantes los scores iban de 3 a 78, con mediana 18. Yo había puesto el corte en 70 sobre algo que se portaba como una escala de 0 a 50. Ese mismo día, veintitrés segundos después de commitear el eval, lo bajé a 25: precision 13 de 15 (87%), recall 13 de 22 (59%).
Fe de erratas: ese día anoté que 25 cumplía los objetivos que yo mismo puse en el SPEC del proyecto (precision arriba de 0.8, recall arriba de 0.6). No los cumplía, y en el mismo párrafo puse que la mediana de las apply era 34, cuando es 33.
El otro bug estaba en el prompt#
La rúbrica es un Markdown que va dentro del system prompt. La v1, la que scoreó las vacantes de agosto, termina con tres ejemplos resueltos. Los sumé:
| Ejemplo | Componentes | Suma real | Score declarado |
|---|---|---|---|
| Senior full stack, Django + Next.js | 33, 24, 20, 6, 8 | 91 | 91 |
| ML Engineer, "Remote (US)" | 8, 15, 4, 2, 5 | 34 | 24 |
| Full Stack Developer, agencia | 18, 10, 8, 0, 0 | 36 | 31 |
Dos de los tres sumaban mal, y los dos para abajo. Con ejemplos, le estaba enseñando al modelo que la nota final es la suma menos algo. Encima, la regla de why_not le pedía bajar el score si no encontraba nada malo en la vacante:
-you cannot find a genuine concern, the score is too high; lower it.
+you cannot find a genuine concern, you have not read the posting closely enough
+— look again. Do not lower the score to compensate for a thin `why_not`: the
+score is the sum of the components and the bullets are a separate obligation.
Mi hipótesis: entre esas dos cosas, el modelo aprendió justo lo que le pedí, sumar bien arriba y recortar en todo lo demás. La v2 de la rúbrica (el diff contra la v1) corrige las sumas, escribe la aritmética en cada ejemplo, cambia esa regla y aclara que el score es la suma y ya:
-**Score: 24, confidence high.** This is the trap case. Shares AI vocabulary with
+**Score: 34, confidence high.** 8 + 15 + 4 + 2 + 5. This is the trap case. Shares AI vocabulary with

-**Score: 31, confidence medium.** Partial stack overlap, React yes but no Python
+**Score: 36, confidence medium.** 18 + 10 + 8 + 0 + 0. Partial stack overlap, React yes but no Python
Dos números en un archivo Markdown. Ningún linter los revisa, ningún test los corre. Hay herramientas para evaluar lo que responde el modelo, e incluso linters de prompts, pero ninguna de las que conozco revisa si las cuentas de los ejemplos suman. Un prompt puede tener un bug de aritmética igual que cualquier otro archivo, con una diferencia: nadie corre tests contra un prompt.
Lo que 39 labels no pueden decir#
Esto parece que resta y es lo que más suma:
- Son 38, no 39: una vacante de Huzzle está dos veces.
- Cero borderline: mide la separación fácil, no el medio difícil.
- Base rate inflado: 22 de 39 son
apply, así que ese 87% es un techo. - 13 de los 17
skipson DevOps o infraestructura, que el stage 2 ya ni deja pasar.
La predicción y el re-score#
Antes de correr la v2, dejé escrita una predicción: los scores van a subir y el threshold 25 va a dejar de ser el correcto.
El re-score costó $0.77, y lo comparé sobre las mismas 39 vacantes: 35 subieron, 2 quedaron igual y 2 bajaron. La mediana del cambio fue +6, pero las apply subieron mucho más que las skip: su mediana pasó de 33 a 47.5, y la de las skip, de 18 a 22.
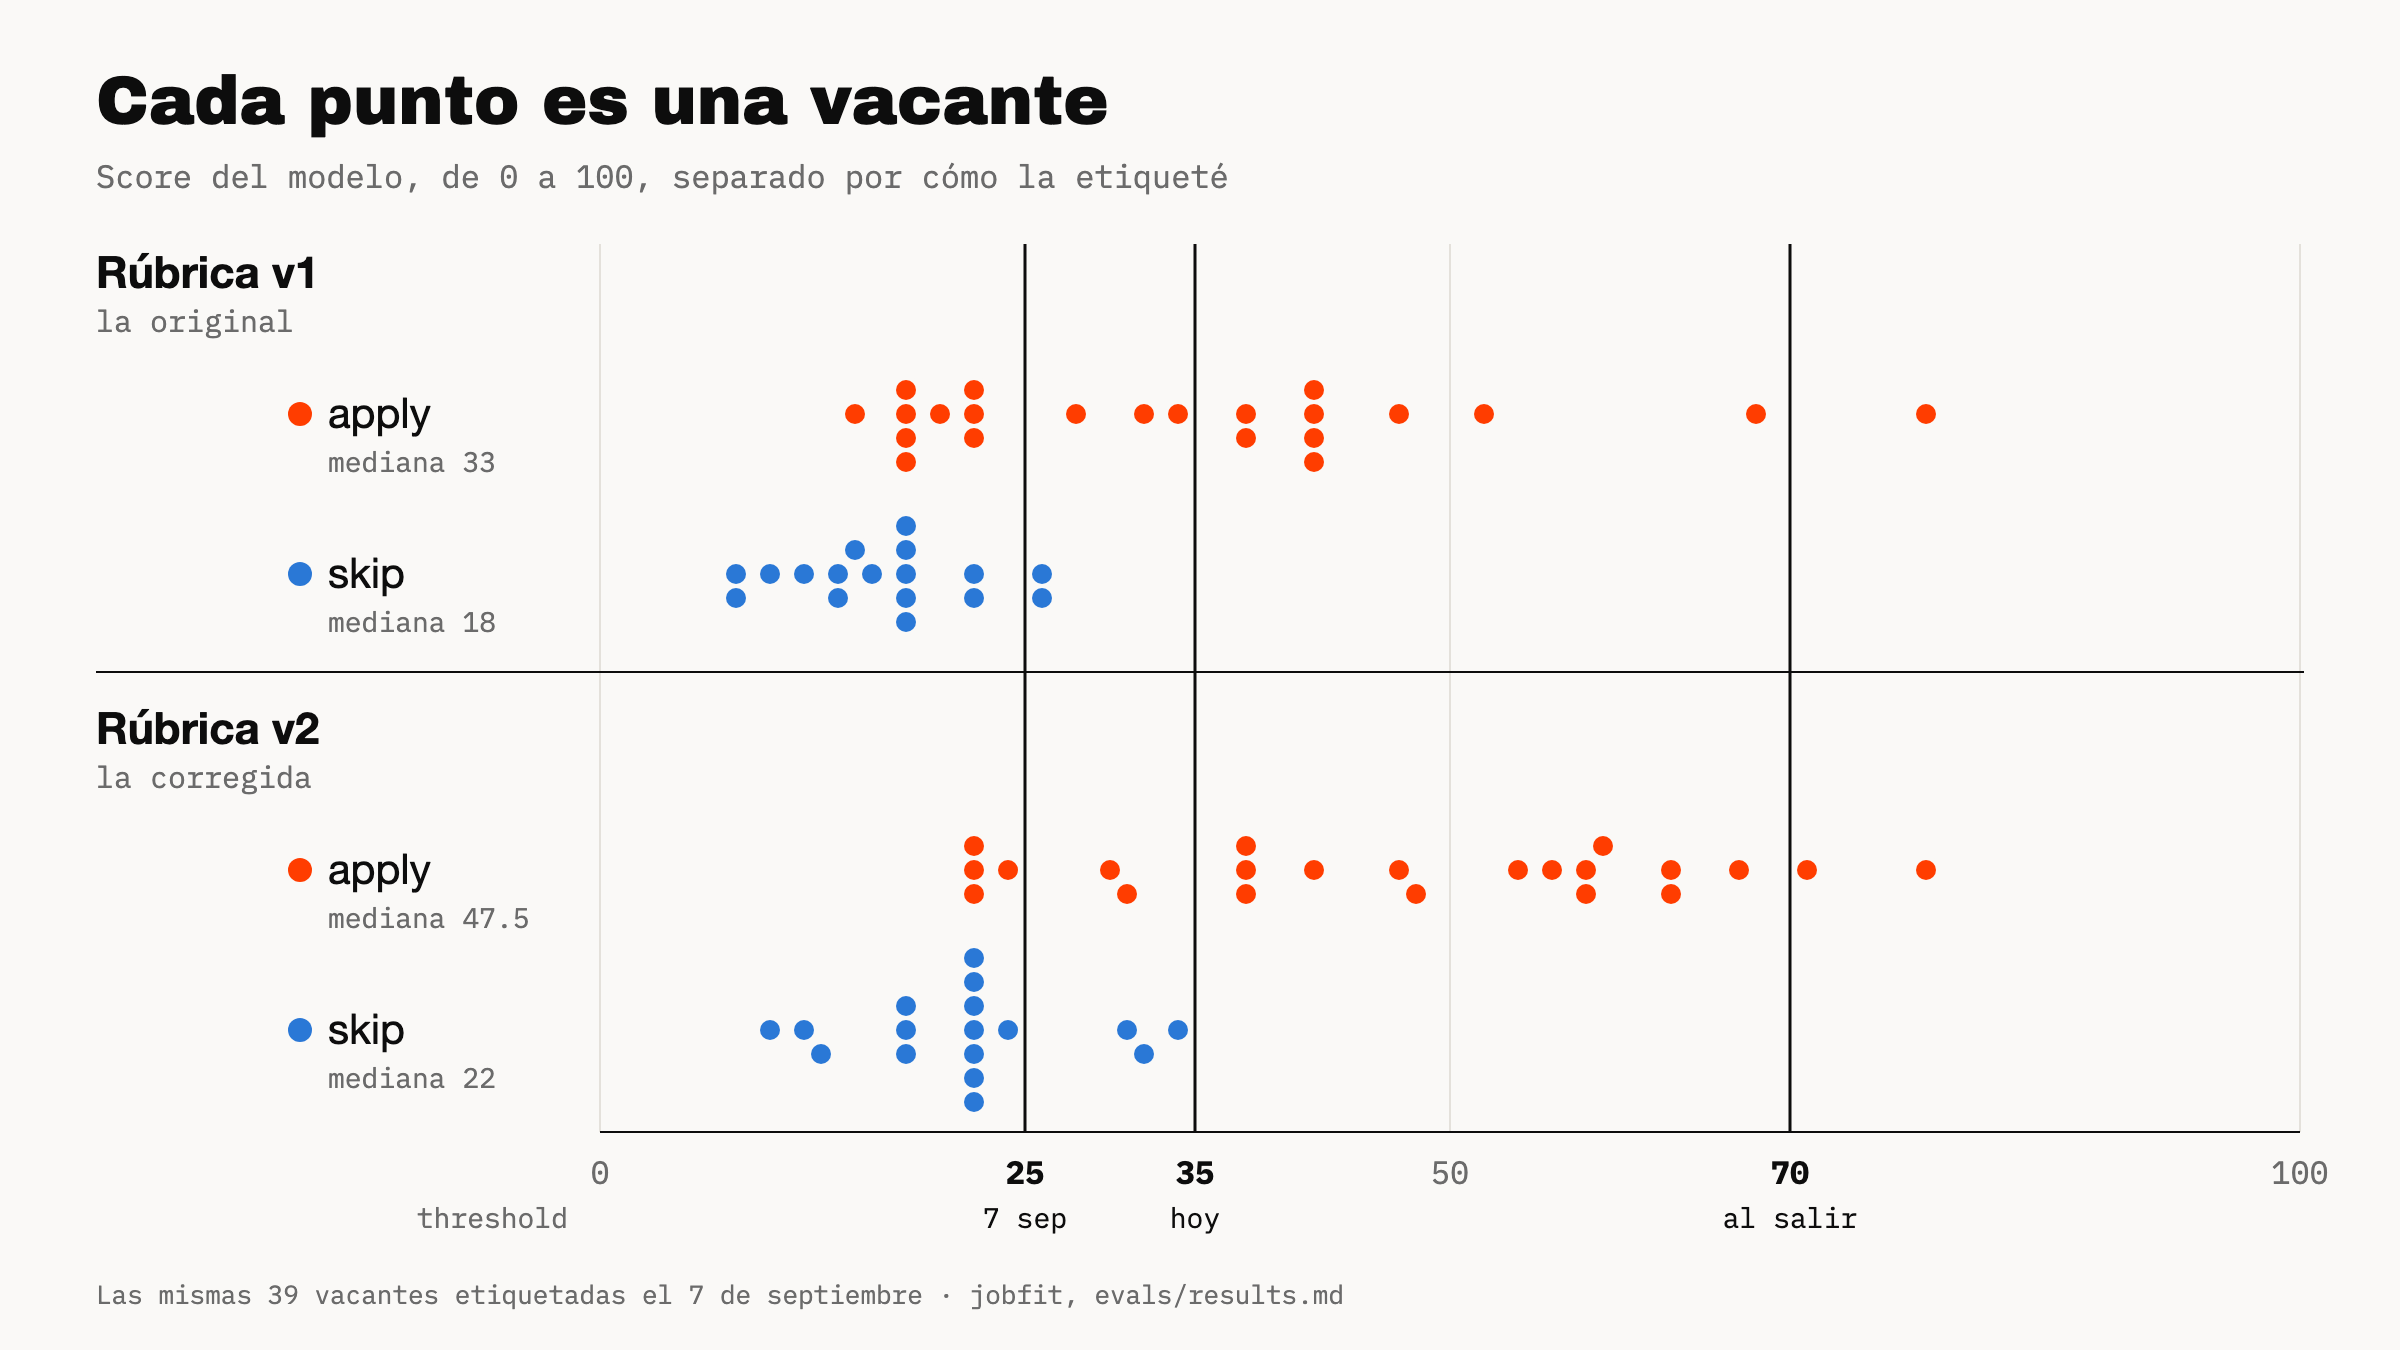 Ver la imagen en tamaño completo
El sweep con las dos rúbricas:
| threshold | v1: precision | v1: recall | v2: precision | v2: recall |
|---|---|---|---|---|
| 70 | 1 de 1 | 1 de 22 | 2 de 2 | 2 de 22 |
| 50 | 3 de 3 | 3 de 22 | 10 de 10 | 10 de 22 |
| 35 | 10 de 10 | 10 de 22 | 16 de 16 | 16 de 22 |
| 30 | 12 de 12 | 12 de 22 | 18 de 21 | 18 de 22 |
| 25 | 13 de 15 | 13 de 22 | 18 de 21 | 18 de 22 |
| 20 | 17 de 21 | 17 de 22 | 22 de 33 | 22 de 22 |
Con la v1, solo 19 y 20 cumplían los dos objetivos del SPEC. Con la v2, cualquier threshold del 23 al 38 los cumple: antes había que atinarle a uno de dos valores, ahora hay una banda.
Después scoreé con la v2 las 123 vacantes que faltaban, por $1.04. De las 163 que hoy pasan el stage 2, 82 quedan en 25 o más: la mitad arriba del corte.
Evaluar un LLM es dejar que los datos te corrijan#
La predicción se cumplió a medias, y cuál mitad falló depende de qué regla del SPEC mire. Por los objetivos numéricos, 25 sigue sirviendo. Pero en el SPEC también me puse la regla de priorizar precision sobre recall: un falso positivo me cuesta veinte minutos, y un falso negativo es una vacante menos entre cientos. Con esa regla, el corte es 35. Con los 53 labels de hoy, 35 da precision 19 de 20 y recall 19 de 30, y 25 da 23 de 28 y 23 de 30.
El threshold sube a 35, en un cambio aparte y sin tocar la rúbrica. Estuve a punto de dejarlo en 25 con un argumento que sonaba prudente, no moverlo sin medir cuánto varía un score entre runs, pero 25 salió justo de ese proceso. Con 35 quedan 59 vacantes arriba del corte en vez de 82.
Lo que falta medir: ninguna vacante se ha scoreado dos veces con la misma rúbrica, así que no sé cuánto del +6 es ruido entre runs, y el set no tiene los diez borderline donde un threshold se gana el sueldo.
Tres veces me fié de lo que creía y tres veces me corrigió una medición. La primera me costó quince días; la segunda, $0.77; la tercera, una consulta mientras escribía este post. La diferencia es que las últimas dos veces había algo escrito que me podía contradecir.
Si tienes un threshold que nadie ha medido, cuéntame cuál es. Los míos están en los resultados del eval, por si quieres revisarlos.